

Deep Research: Lass deinen Agenten nicht halluzinieren
 von Johannes Hoppe
Gescheite Recherche mit AI klingt einfach: Befehl absetzen, Ergebnis abholen. Ich nutze dafür Claude Code und den Befehl /deep-research, im Prinzip läuft das in jeder Agenten-Umgebung (engl. Harness) gleich. Und in jedem wird fleißig halluziniert. Dieser Artikel zeigt, warum das passiert und was dagegen hilft: eine globale Regel (in der globalen CLAUDE.md), ein Werkzeug, das Quellen wirklich liest, ein Faktencheck an der Primärquelle, und am Ende der Autor selbst.
Inhalt
- Wie läuft die Recherche ab?
- Woher kommt die Halluzination?
- Die erste Gegenmaßnahme: eine globale Regel
- Nicht ausgesperrt werden: der Playwright-MCP
- Der Faktencheck: jede Behauptung gegen die Quelle
- Die letzte Instanz: der Autor prüft selbst
- Fazit
Wie läuft die Recherche ab?
Du sagst deiner Hauptunterhaltung: recherchiere etwas zu einem Thema. Das kann eine Library fürs Programmieren sein oder ein Fakt für einen Artikel. Die AI soll dir Arbeit abnehmen.
Dafür startet die Hauptunterhaltung einen Workflow. In Claude Code genügt ein Befehl: /deep-research <deine Frage>. Das ist Claude Codes einziger mitgelieferter Workflow, und er läuft nur, wenn ich ihn selbst auslöse, nicht wenn das Modell nebenbei auf die Idee kommt. Eine tiefe Recherche kostet Zeit und Tokens, das entscheide ich bewusst. Welche Claude-Code-Befehle sich sonst noch lohnen, steht in 10 Claude-Code-Befehle, die du kennen solltest.
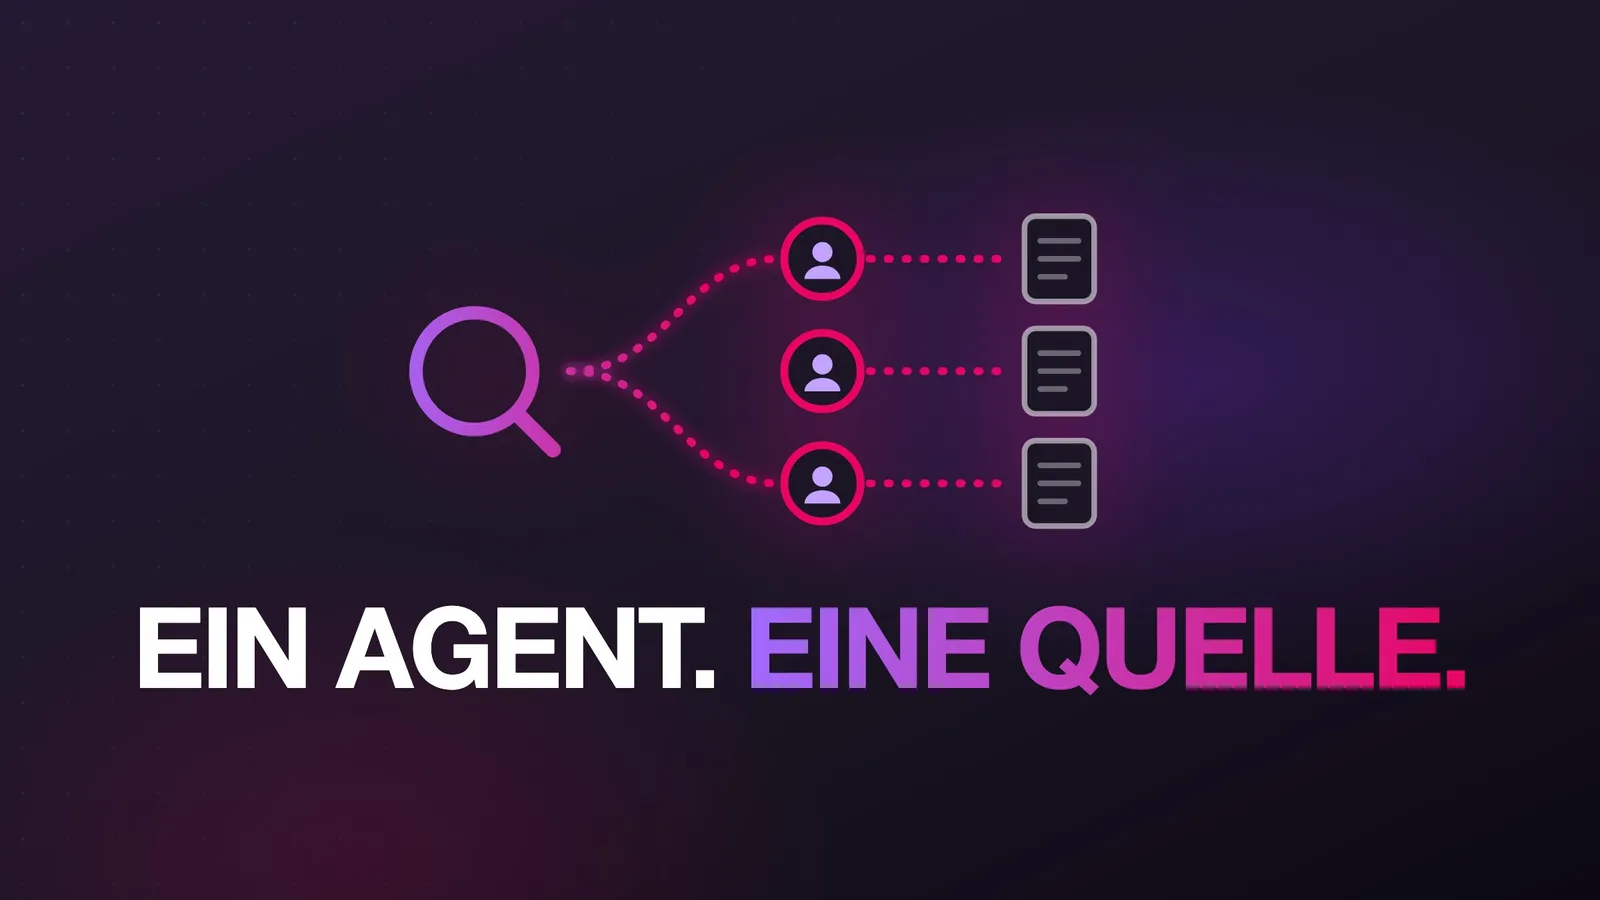
Die Grundlage sind Suchergebnisse einer Suchmaschine: zu jedem Treffer eine Adresse und eine kleine Suchvorschau. Damit werden dann die Subagenten beauftragt, die Seiten tatsächlich zu lesen. So weit würde es ein Mensch genauso machen. Technisch fächert /deep-research die Arbeit über ein Orchestrierungs-Skript auf viele Subagenten auf. Zusammen bilden sie einen Graphen. Wie so ein Graph aufgebaut ist und wie man solche Skripte selbst schreibt, steht in Graph Engineering. Der Workflow läuft dabei in fünf Stufen:
- Zerlegen: Die Frage wird in fünf Teilfragen aufgespalten, fünf verschiedene Blickwinkel.
- Suchen: Pro Blickwinkel läuft ein eigener Such-Agent, alle fünf parallel.
- Holen: Die Treffer werden entdoppelt, dann holt für jede Quelle ein eigener Agent die Seite und zieht die überprüfbaren Einzelbehauptungen heraus, bis zu fünfzehn Quellen, jede in ihrem eigenen Kontext. So sind die Agenten beim Durchlesen isoliert voneinander.
- Prüfen: Jede Behauptung bekommt drei unabhängige Prüfer, die sie adversarial angehen (gegnerisch, mit dem Ziel zu widerlegen). Erst wenn zwei von dreien sie widerlegen, fliegt sie raus.
- Zusammenfassen: Nur was die Prüfung übersteht, wird zusammengeführt, nach Vertrauen sortiert und mit Quellen belegt.
Woher kommt die Halluzination?
Das klappt, solange die Seiten sich lesen lassen. Nur sperren in letzter Zeit immer mehr Webseiten Crawler aus, und damit auch deinen Bot. Dann sieht der Agent einfach gar nichts. Jetzt gibt es mehrere Möglichkeiten, was passiert:
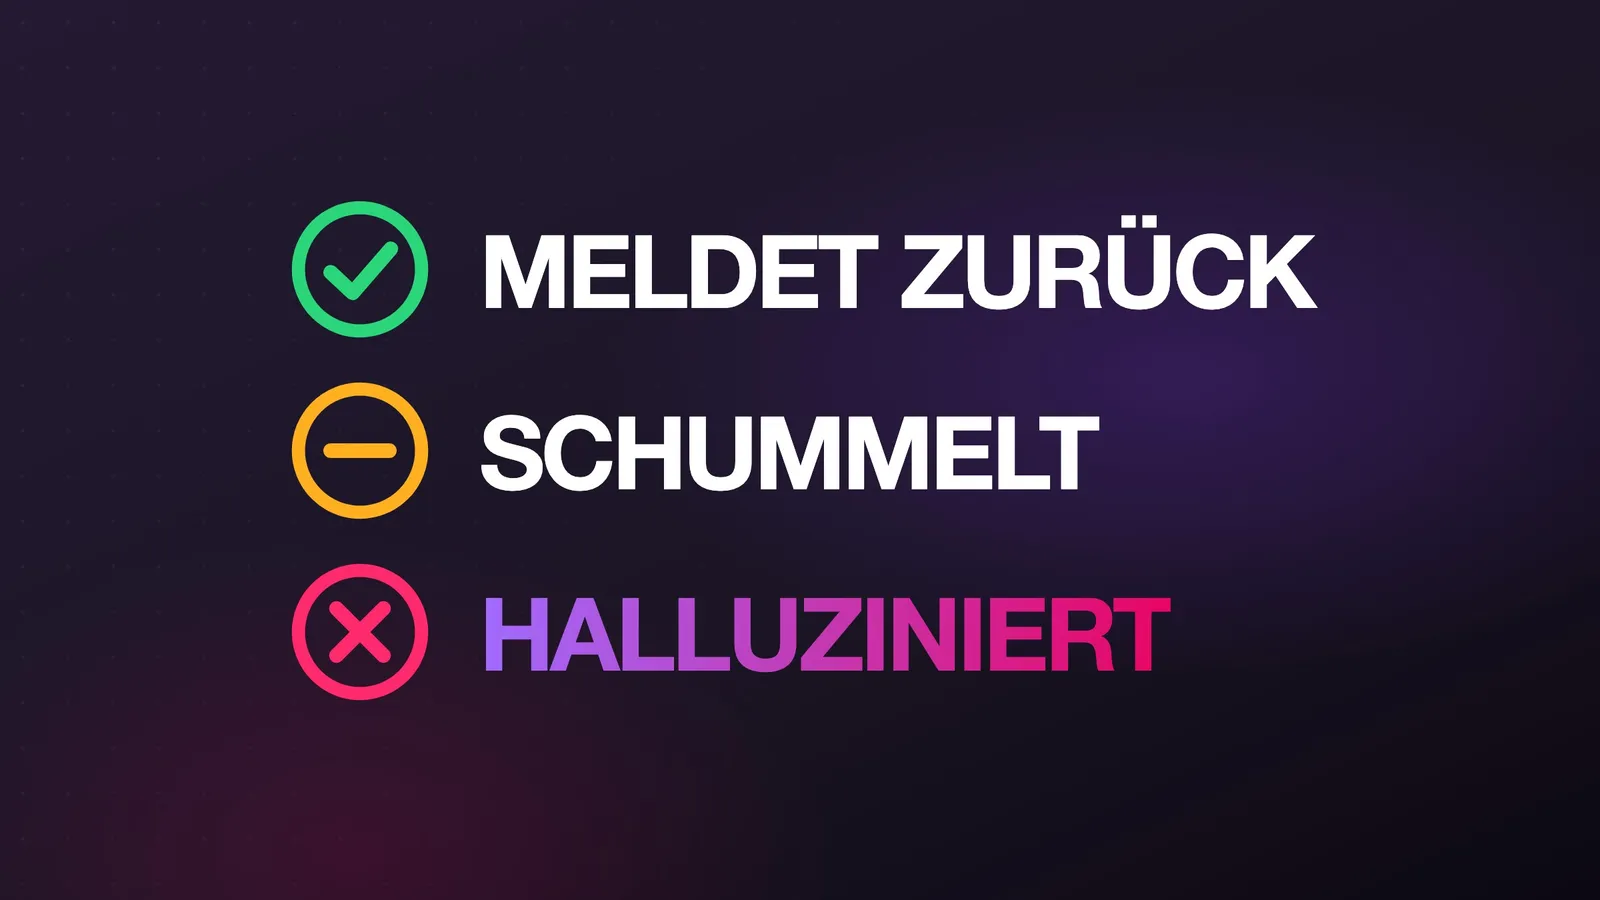
Im besten Fall meldet er es zurück: diese Quelle konnte ich nicht lesen. Dann weiß die Hauptunterhaltung Bescheid. Es kann aber auch passieren, dass er die Suchvorschau nimmt und sich den Rest dazu denkt, halb geschummelt, halb halluziniert. Und die Vorschau muss nicht einmal aktuell sein: Jedes Suchergebnis trägt ein Alter mit (page_age), sie kann also einen älteren Stand zeigen. Der schlechteste Fall: Er erfindet die Antwort komplett. Nichts davon stimmt.
Das liegt in der Natur der LLMs. Sie liefern kein gesichertes Wissen. Sie erzeugen Text, der plausibel klingt. Das muss man immer mitdenken: Es kann auch völliger Mumpitz sein. Die Ergebnisse kommen zurück, und du hast ein Problem.
Die erste Gegenmaßnahme: eine globale Regel
Damit ich nicht bei jeder Recherche sagen muss „prüf das bitte alles selbst", habe ich eine globale Regel hinterlegt, die von vornherein Misstrauen sät. In meiner globalen CLAUDE.md (sie liegt unter ~/.claude/CLAUDE.md), die in jeder Sitzung mitläuft, steht sie im exakten Wortlaut:
## CRITICAL: Web Research Agents Hallucinate

**Sub-agents that research the web (Task tool with WebSearch/WebFetch) frequently hallucinate technical details.** They confidently fabricate config paths, API behavior, parameter names, and causal explanations that sound plausible but are wrong.

**HARD RULES:**
- **NEVER** write research agent output directly into documentation or code without verifying it
- **ALWAYS** verify claims against actual source code, bundled docs, or observed behavior (read the log, check the output)
- **NEVER** state something as fact unless directly observed — if the cause is unknown, say "unknown"
- **NEVER** invent plausible-sounding explanations to fill gaps in understanding
- The difference between "we observed X" and "X happens because Y" is critical
Die Regel verlangt zweierlei: beobachtet und vermutet auseinanderhalten, und Unbekanntes als unbekannt benennen, statt die Lücke mit einer schönen Erklärung zu stopfen. Das nimmt dem Modell die Erlaubnis zu raten. Und sie erreicht genau die richtigen: Jeder Recherche-Subagent lädt diese globale CLAUDE.md beim Start mit, nicht nur die Hauptunterhaltung. Die Datei ist ganz normaler Text, Claude darf diese Regel bei Bedarf also auch selbst anpassen und erweitern.
Das hilft spürbar. Da kommt vieles zutage, was sonst durchgerutscht wäre.
Nicht ausgesperrt werden: der Playwright-MCP
Gegen das Aussperren selbst lässt sich auch etwas tun. Ich habe Claude einen eigenen Playwright-MCP gegeben (Playwright steuert einen echten Browser), der sich möglichst gut tarnt. Er ist nicht mehr von Weitem als automatisiertes Tool zu erkennen, weil die verräterischen Browser-Flags deaktiviert sind, und kommt so durch die meisten Seiten. Das entschärft das Problem deutlich, gelöst ist es damit aber nicht. Wie das genau geht, habe ich in einem eigenen Artikel beschrieben: Gib deinem Agenten einen eigenen, unauffälligen Playwright-MCP.
Der Gewinn: Der Agent liest die Seite dann wie ein Mensch und zitiert den exakten Wortlaut der Quelle, statt eine Zusammenfassung aus zweiter Hand. Trotzdem bleibt eine Lücke. Die Funde laufen nach oben an die Hauptunterhaltung, und die muss jede Quelle selbst gegenprüfen, bevor sie sie übernimmt. Genau das erledigt die Regel von oben, ohne dass ich es jedes Mal dazusagen muss.
Der Faktencheck: jede Behauptung gegen die Quelle
Eigentlich sollte Deep Research mit seiner Prüfstufe doch halluzinationsfrei sein. Ist es aber nicht, und der Grund ist strukturell. Die drei Prüfer in der Recherche vergleichen jede Behauptung nur gegen das Zitat, das der Agent aus der Hol-Stufe (Stufe 3) selbst mitgeliefert hat, und suchen per Websuche nach Widerspruch. Die Originalseite lesen sie dabei nicht noch einmal. Hat der Agent das Zitat gleich miterfunden, passt die erfundene Behauptung zum erfundenen Zitat, und sie besteht die Prüfung. Die Recherche prüft sich also teils gegen sich selbst, statt frisch an der Quelle.
Deshalb kommt bei mir, wenn eine Faktenlage dasteht, ein weiterer Workflow, den ich mir gebaut habe: ein Lektorat. Es nimmt sich den fertig zusammengeführten Text vor, samt Zitaten, und prüft ihn frisch gegen die Primärquellen. Es sucht nach Behauptungen, nach angeblichen Fakten und nach angeblichen Zitaten und prüft jede einzeln an der Quelle. Grundhaltung Zweifel: Eine Behauptung gilt erst als gesichert, wenn die Quelle sie wörtlich deckt, nicht schon, wenn sie plausibel klingt.
Besonders die Zitate: Oft sind sie nicht exakt zitiert, sondern nur zusammengefasst. Dann gilt die Nachfrage: Ist das ein Zitat? Dann zeig mir bitte genau die Stelle. Und wieder stellst du fest, dass einiges durchgerutscht ist. Diesen Durchlauf kannst du mehrfach laufen lassen, bis das, was dasteht, auch der Realität entspricht.
Die letzte Instanz: der Autor prüft selbst
Ganz trauen kannst du dem immer noch nicht. Wenn Claude die grobe Arbeit für einen Artikel gemacht hat, lese ich am Ende alle Quellen selbst noch einmal quer. Ich schaue, ob das, was dort als Fakt behauptet wird, auch tatsächlich so in der Quelle steht. Erst dann gebe ich den Text zum Lesen frei.
Am Ende hat der Autor also immer noch die Aufgabe, das Ganze auf Plausibilität zu prüfen. Das finale Lektorat macht der Mensch, der Human in the Loop (der Mensch, der im Prozess bleibt). Befolgst du das alles, ist es eine große Erleichterung für die Arbeit, und du bekommst meiner Meinung nach fundierte Ergebnisse. Lässt du es weg, ist es am Ende herrlicher AI-Slop (ungeprüfter, minderwertiger KI-Output), und den kennst du zur Genüge.
Fazit
Eine einzelne Maßnahme reicht gegen Halluzinationen nicht. Vier Schichten wirken zusammen. Eine Regel nimmt dem Modell die Erlaubnis zu raten. Ein getarnter Playwright-MCP sorgt dafür, dass wirklich die Quelle gelesen wird und nicht eine Vorschau. Ein Faktencheck prüft jede Behauptung gegen die Primärquelle. Und der Autor liest am Schluss selbst gegen. Zusammen halten sie den Agenten bei der Wahrheit, und das letzte Wort hat ohnehin der Mensch.
Mein Rat: Fang mit der Regel an. Lass Claude sie in deine globale CLAUDE.md eintragen, dann wirkt sie sofort. Den Rest baust du nach und nach dazu. Und dieser Artikel hier? Der ist hoffentlich halluzinationsfrei. 😅
Fragen, Feedback, dein eigenes Setup? Immer her damit, ich freue mich über jede Nachricht.
Neugierig auf agentisches Arbeiten in der Praxis? In den Workshops von agentic.schule und angular.schule zeigen wir, wie moderne KI-Agenten die tägliche Entwicklung verändern.
Keywords:Deep ResearchHalluzinationClaude CodeAgentic CodingFaktencheckPlaywrightMCPWeb-Recherche
Anregungen? Feedback? Fehler?
Über den Autor
 Johannes Hoppe ist Trainer und Berater für moderne Web-Entwicklung. In den Workshops von angular.schule und agentic.schule geht es praxisnah um Angular – und zunehmend um agentische Entwicklung mit KI-Agenten wie Claude Code.