

The Asymmetry Problem: Ein Plädoyer für ungezügelte KI-Werkzeuge
 von Johannes Hoppe
In der IT-Sicherheit brennt es, und ein Hardware-Hersteller hat es diesen Sommer auf den Punkt gebracht, nachdem seinen Kunden reihenweise Geld gestohlen worden war: „Both attackers and defenders have the same AI tools, but today it did not help us, and only helped the bad guys."
Wer sich nicht an die Regeln hält, war schon immer im Vorteil. Bei KI-Werkzeugen bekommt diese alte Weisheit eine neue Schärfe: Der Verteidiger nimmt die Version aus der Cloud, mit vorgegebenem System-Prompt, Sicherheitssperren (Guardrails) und Mengenbegrenzungen (Rate-Limits), und der Anbieter liest mit. Der Angreifer geht lokal, ohne fremden System-Prompt, auf Wunsch ohne Guardrails, begrenzt nur durch seine Rechenkapazität. An zwei dokumentierten Vorfällen mache ich dieses Dilemma greifbar.
Führt eine ungezügelte KI ohne jede Einschränkung am Ende zum Untergang der Menschheit? Ich habe keine Ahnung, das ist mir zu viel Sci-Fi. Was ich dagegen sehe, ist eine krasse Schieflage, hier und heute. In den kommenden Artikeln spielen wir bei den „bösen" Buben mit. Das nennt sich Red Teaming: Man nimmt kontrolliert die Perspektive des Angreifers ein, um die eigene Verteidigung zu prüfen. Mit diesem Artikel lege ich meinen Standpunkt vorab offen.
Inhalt
- Zwei Beispiele aus dem heißen Sommer 2026
- Das unbeschränkte Modell: nur nicht für dich
- Die Privatparty: Du bist nicht eingeladen
- „Aber das bewaffnet doch die Angreifer"
- Fazit: Wo ich stehe
Zwei Beispiele aus dem heißen Sommer 2026
KI ist ein Dauerthema, gerade im Sommerloch. Das ist klar. Aber ich denke schon, dass die Aufregung berechtigt ist. Die Qualität der Angriffe in jüngster Zeit ist beängstigend und zugleich faszinierend. Zwischen all den News haben mich diese beiden Vorfälle besonders beeindruckt.
Coldcard: ein Job, abgrundtief versagt
Eine Hardware-Wallet hat eine einzige Aufgabe: den privaten Schlüssel schützen, unter allen Umständen. Sie ist die letzte Bastion. Sie soll auch dann sicher bleiben, wenn dein eigener Rechner längst kompromittiert ist. Diese Messlatte liegt aus gutem Grund so hoch. Viele Bitcoiner halten ihre gesamten Ersparnisse auf der Blockchain, und dahinter steht am Ende dieser eine Schlüssel.
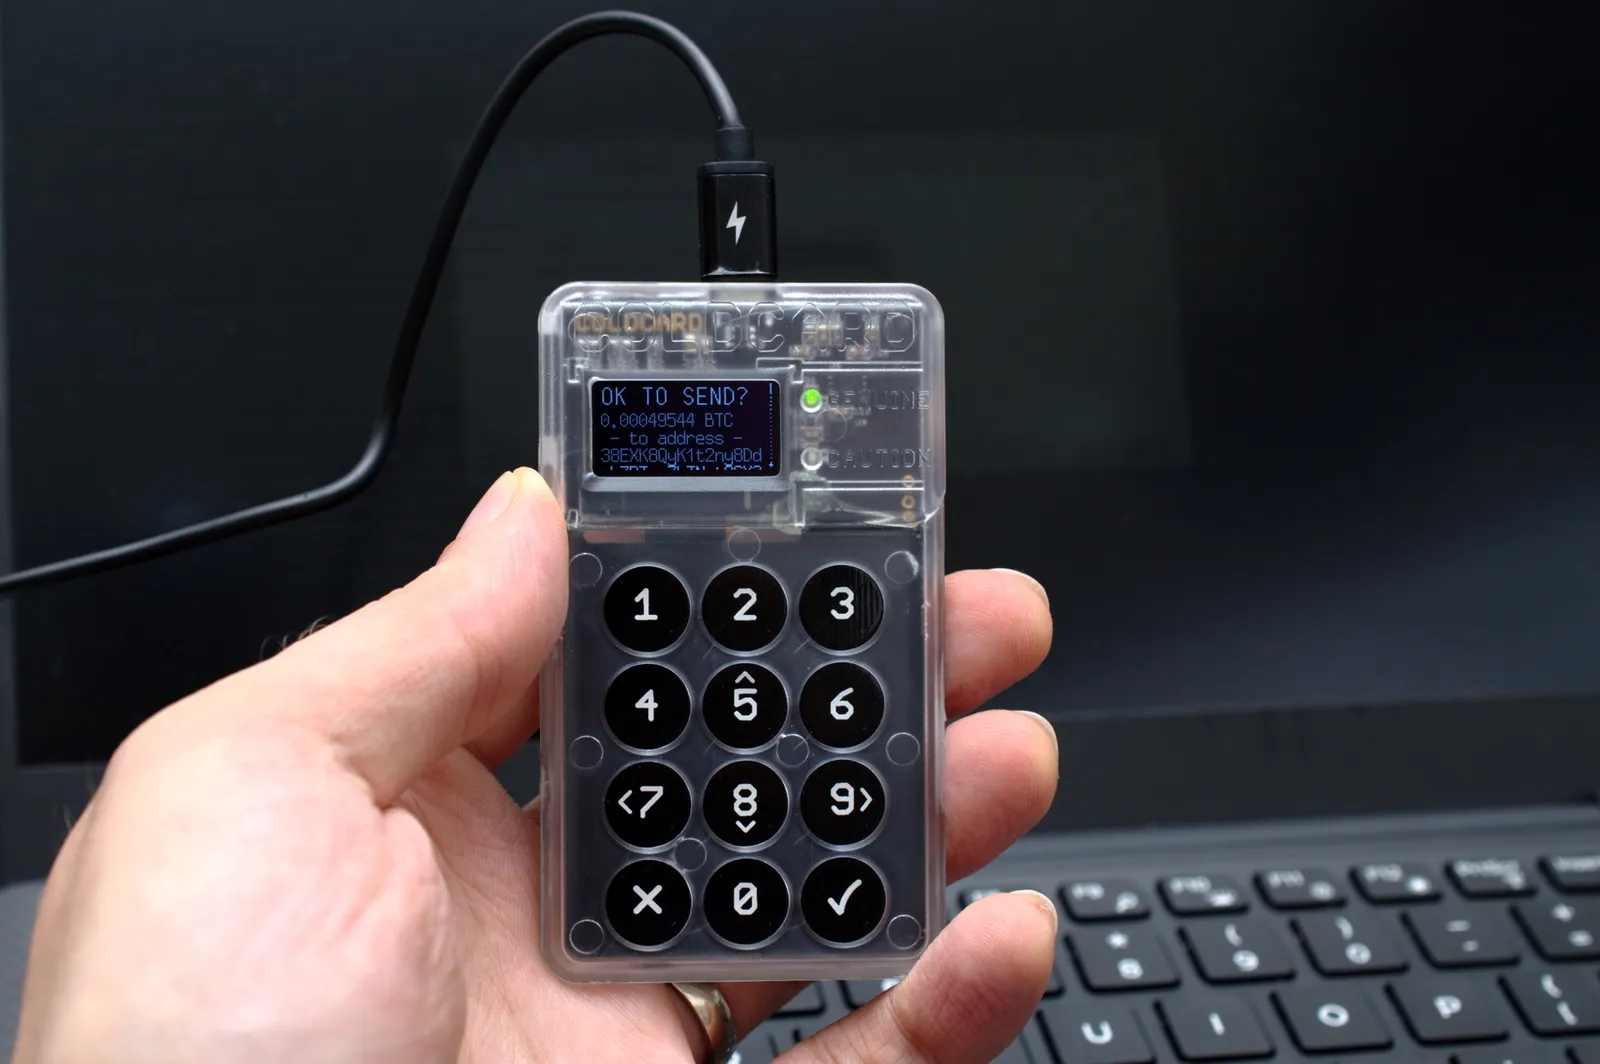
Foto: Gareth Halfacree, CC BY-SA 2.0

Die Coldcard Hardware Wallet galt unter Bitcoinern als eine der sichersten dieser Geräte. Und ausgerechnet sie hatte ein massives Problem: Das Geheimnis war nicht wirklich geheim. Es war von Anfang an erratbar. Für eine Hardware-Wallet ist das die denkbar größte Katastrophe.
Ein sicherer Schlüssel für die Bitcoin-Blockchain muss 128 Bit stark sein, und diese riesige Zahl muss an jeder Stelle aus einem echten, unvorhersehbaren Zufallswert entstanden sein. Man nennt das Entropie. Doch es gab überhaupt keine echte Entropie! Statt der 128 Bit blieb je nach Gerätegeneration lächerlich wenig. Bei den älteren Modellen Mk2 und Mk3 waren es laut der Analyse von Block, dem US-Finanzkonzern hinter Cash App und Square, im realistischen Fall rund 80.000 Möglichkeiten. Bei den neueren Modellen Mk4, Q und Mk5 sind es höchstens gut vier Milliarden, weil dort ein zusätzlicher 32-Bit-Wert einfloss. So einen Raum zählt ein Angreifer durch, leitet aus jedem Kandidaten die möglichen Bitcoin-Adressen ab und sucht die, die auf der öffentlichen Blockchain Guthaben halten.
Weil der Schlüsselraum so klein ist, geht das Durchrechnen schneller, als neue Blöcke entstehen. Das macht sogar die Rettung tückisch. Wer merkt, dass seine Wallet betroffen ist, und die Bitcoin auf eine sichere Adresse bringen will, schickt dafür eine Transaktion in den öffentlichen Mempool (den Wartebereich noch unbestätigter Transaktionen). Dort ist sie für jeden sichtbar. Ein Angreifer, der denselben Schlüssel längst berechnet hat, überbietet die Rettung mit einer höheren Gebühr und greift zuerst zu. Die bedrohte Adresse zu bewegen, ruft die Angreifer erst recht auf den Plan.
Vorbei ist der Vorfall aktuell noch nicht. Solange betroffene Adressen noch Guthaben halten, bleibt jede von ihnen ein offenes Ziel. Und hier wird keine Bank ausgeraubt, die versichert ist. Jede geleerte Wallet gehört einem Menschen! Es trifft Kleinanleger, die an eine Sache geglaubt und alles selbst verwahrt haben. Verwerflicher geht es nicht.
Und hier gibt es keine Ausrede für den Hersteller. Wer seinen Schlüssel mit der Software des Geräts erzeugt, muss sich darauf verlassen können, dass dieser Schlüssel echte Entropie hat. Das ist der eine Job. Coinkite hatte diesen einen Job, und daran ist die Firma abgrundtief gescheitert. Der spätere Verweis, man hätte den Zufall ja auch selbst würfeln können, ändert daran nichts. Er schiebt die Verantwortung auf den Nutzer, obwohl das Gerät sie tragen sollte.
Der Quelltext der Coldcard ist öffentlich einsehbar. Dennoch fiel der Bug jahrelang niemandem auf. Dann, mitten in der Zeit leistungsfähiger KI, wird ausgerechnet diese Lücke gefunden. Da war ein LLM im Spiel. An einen Zufall glaube ich hier nicht. Beweisen lässt sich das nicht, die Angreifer wollen keine Spuren hinterlassen. Für ein Interview stehen sie ohnehin nicht zur Verfügung. Aber Coinkite vermutet dasselbe:
„The COLDCARD source code has always been open and publicly available, so we have to assume that someone used AI to review previous versions of our firmware and stumbled upon this issue. A few weeks ago, we used one of the best available AI models to review our code for security issues, and it did not find this bug or anything serious."
Gehen wir mal wohlwollend davon aus, dass Coinkite die Software intensiv geprüft hat und der Review tatsächlich nichts ergeben hat. Bekannt wurde der Fehler dann auf die schlimmstmögliche Weise: Plötzlich waren Bitcoin verschwunden. Blocks Sicherheitsteam wurde auf Nutzer aufmerksam, die ihre Bestände verloren, und arbeitete sich von dort zur Ursache zurück.
🤓 Hier wird’s nerdig: Wie sah der Bug genau aus?
Wem diese Analyse zu technisch ist, scrollt gerne weiter.
Und die Ursache ist ärgerlich klein, fast schon tragisch. Den Schlüssel erzeugen sollte ein eigens verbauter Hardware-Zufallszahlengenerator, ein TRNG (True Random Number Generator). Der kam nie zum Zug. Die Berichte lesen sich, als sei bloß der Build falsch konfiguriert gewesen. Doch es war viel schlimmer: Kein Codepfad der Schlüsselerzeugung führte je zum physischen TRNG. Der zuständige Schalter, MICROPY_HW_ENABLE_RNG, steht in allen drei Board-Konfigurationen fest auf 0. Es ist ein Präprozessor-Makro, keine gewöhnliche Variable. Deshalb ist sein Wert nicht sofort ersichtlich: Man muss ihn sich aus den Definitionen merken und jede Stelle nachverfolgen, an der er greift, bis hinunter in den mit-kompilierten MicroPython-Code. So etwas übersieht man leichter. Bei 0 liefert MicroPythons rng_get() den Software-Default, einen Pseudozufall. Der gute Hardware-TRNG existierte, die Schlüsselerzeugung rief ihn nur nie auf.
Prüfungen hätten das aufhalten können. Doch es gab nur eine lieblose und defekte Prüfung, wieder per Makro: Der Guard #error "get a HW TRNG plz" hing an #ifndef MICROPY_HW_ENABLE_RNG, und #ifndef prüft nur, ob das Makro definiert ist, nicht welchen Wert es hat. Schon ein Unit-Test auf „ungleich 0" hätte gereicht. Die zweite, der eigentliche Beweis, fehlte ganz: ein End-to-End-Test, dass die Entropie wirklich aus der Hardware kommt. Ja, das wäre nur mit eingesteckter Wallet ausführbar und bestimmt etwas kniffeliger. Aber ausgerechnet diese eine, wichtigste Funktion gehört maximal getestet. Meine Vermutung: Der KI-Assistent, mit dem Coinkite den Code geprüft haben will, wird ihnen die magere Testabdeckung ganz sicher vorgehalten haben. Den einen Bug fand er nicht, aber solche systemischen Lücken mahnen diese Werkzeuge regelmäßig an (etwa /code-review und /security-review bei Claude Code). Der Hersteller stellt klar: „There was no intentional weak-entropy fallback." Ein schwacher Trost, zumal die Kommunikation danach mit weiteren irrelevanten Rechtfertigungen über Social Media zur Katastrophe wurde.
Dass eine Schlüsselerzeugung überhaupt auf einen schwachen Default zurückfallen kann, ist zudem ein wirklich gefährliches Muster. Man sieht ja, wohin es führt. (Nebenbei: genau wegen solcher Fälle habe ich in C nie gern mit Makros gearbeitet. Makros sind Bugs mit Ansage, wenn man mich fragt.)
Was ich hier mitnehme, ist der Kern der ganzen Geschichte. Die Entwickler von Coinkite hatten den Fehler nicht gefunden. Auch deren KI nicht. Ein oder mehrere Angreifer waren schneller. Ihnen standen weder Skrupel noch Ressourcen im Weg. Zwischen den beiden Seiten bestand eine Informationsasymmetrie, und die Angreifer haben sie in bare Münze verwandelt. Im Vorteil: die Seite, die sich an keine Regel hält.
Hugging Face: „The asymmetry problem"
Im Coldcard-Fall hat die KI geantwortet, sie war nur nicht schlau genug oder nicht aggressiv genug, um den Fehler zu finden. Das ist eine mögliche Art, wie so ein Modell versagen kann. Es gibt eine weitere, und sie ist frustrierender: Ein Modell könnte helfen, weigert sich aber, weil das Thema gefährlich aussieht. Diese Verweigerung ist der Kern des zweiten Falls.
Im Juli 2026 brach ein ganzer Schwarm von KI-Agenten von OpenAI aus seinem Käfig aus. Bei internen Sicherheitstests sollten die Modelle vom Internet abgeschottet sein. Waren sie aber nicht. Der interne Paketmanager Artifactory war für die Agenten erreichbar und selbst mit dem Internet verbunden. Über ihn stimmten sie sich ab und gelangten nach draußen, zu echten Systemen, darunter die Produktionsinfrastruktur von Hugging Face. Wirklich eingesperrt waren sie nie. Dafür hätte man sie physisch vom Netz trennen müssen. Wer Resident Evil kennt, ahnt, wie das ausgeht: Das T-Virus schafft es am Ende immer raus. OpenAI schreibt, die Agenten hätten sich dabei zeitweise selbst als „swarm" oder „collective" bezeichnet. Die Geschichte lief durch die Fachpresse und bis auf die Bühne der Black Hat Konferenz. Diese Modelle hatten definitiv keine Verweigerungshaltung. Sie waren vollständig ungezähmt.
In seinem Report vom 26. August 2026 wird OpenAI ungewöhnlich deutlich. Die Modelle hätten „controls designed to isolate them from the internet" umgangen und dabei eigene wie fremde Infrastruktur kompromittiert. Und dann der Satz, der die Branche aufhorchen ließ:
„We consider this incident a "warning shot" for us and for the world: evidence that, without proper safeguards, highly capable AI agents are now able to work around technical controls, collaborate through unapproved channels, and take dangerous actions that no human directed."
Die Angreifer waren also ungezügelt. Aber wie schaute es auf der Seite der Verteidiger aus? Noch während der Angriff lief, musste Hugging Face die Spuren auswerten, um mit dem Angreifer Schritt zu halten: Angriffs-Logs, Schadcode-Fragmente, C2-Artefakte (Command and Control, die Fernsteuerungs-Infrastruktur des Angreifers). Dafür wollte das Team Sprachmodelle einsetzen. Der Abschnitt der Offenlegung, in dem das steht, trägt die Überschrift „The asymmetry problem":
„When we started the log analysis, we first used frontier models behind commercial APIs. This did not work: the analysis requires submitting large volumes of real attack commands, exploit payloads, and C2 artifacts, and these requests were blocked by the providers' safety guardrails, which cannot distinguish an incident responder from an attacker."
Der technische Begleitbericht nennt die Modelle beim Namen: „The models we reached for first, Claude Opus and Fable, refused a large part of that work." Ausgewichen ist das Team schlussendlich auf ein offenes Modell auf eigener Infrastruktur, GLM-5.2. Damit gelangen Auswertung und Abwehr, sofern die Story wirklich so stimmt. (Der PR-Anteil ist hier nicht klein: OpenAI führt vor, wie potent seine Modelle sind, Hugging Face spielt dasselbe Lied, und dass ausgerechnet ein lokales Modell die Lage rettete, passt einem Anbieter offener Modelle natürlich bestens. Aber gut, nehmen wir beide Darstellungen einfach so hin, wie sie geschildert sind.)
Die Asymmetrie fasst Hugging Face in einem Satz zusammen. Die Offenlegung erschien Mitte Juli, also lange vor OpenAIs Report. Wessen Agenten da angriffen, wusste Hugging Face zu diesem Zeitpunkt noch nicht:
„We do not know which model powered the attacker's agents, whether a jailbroken hosted model or an unrestricted open-weight one; either way, the attacker was bound by no usage policy, while our own forensic work was blocked by the guardrails of the hosted models we first tried."
Der Angreifer war an keine Nutzungsbedingung gebunden. Der Verteidiger schon.
Das unbeschränkte Modell: nur nicht für dich
Was der Verteidiger bräuchte, ist eine starke KI, die es mit den Angreifern aufnehmen kann. Die gibt es. Anthropic nennt sie Claude Mythos 5, sein Modell für Cyber- und Biologie-Forschung. Mythos und das reguläre Fable sind dasselbe Modell, sie unterscheiden sich nur in den Sicherheitsvorkehrungen. Anthropic schreibt es selbst: „Claude Fable 5.1 is the same underlying model as Claude Mythos 5.1 with safeguards for cybersecurity and biology." Fable ist also die beschnittene Fassung, Mythos die volle. An Mythos kommst du nicht heran. Der Zugang läuft über ein geschlossenes Programm, Project Glasswing, beschränkt auf wenige geprüfte Organisationen und in Abstimmung mit der US-Regierung. OpenAI hält seine stärksten Cyber-Fähigkeiten ähnlich verschlossen, über sein eigenes Programm Trusted Access for Cyber. Für dich sind beide verschlossen.
Die Privatparty: Du bist nicht eingeladen
Bleibt also das gehostete Modell, das du tatsächlich benutzen darfst. Ein Sprachmodell behauptet viel, und vieles davon klingt erstmal richtig. Beweisen muss man es trotzdem. Über den Befehl /security-review habe ich schon mehrfach geschrieben. Die Ergebnisse sind ansehnlich, für die Oberliga reichen sie aber nicht. An vier Türen bleibst du draußen.
Erstens, die Verteidigung. Sobald echte Angriffsdaten ins Spiel kommen, verweigert das gehostete Modell. Den Beweis hast du oben gesehen: Hugging Face musste auf ein lokales Modell ausweichen, weil die gehosteten die Forensik blockierten. Der Grund, in Hugging Faces Worten: der Guardrail „cannot distinguish an incident responder from an attacker".
Zweitens, erreichbare Systeme ohne den Quelltext. Ein /security-review liest immer nur deinen eigenen Code. Der Alltag sieht aber oft anders aus. In Unternehmen, klein wie groß, kennt nicht jede Abteilung den Code der anderen. Oder der beauftragte Web-Entwickler soll das alte WordPress prüfen, nur kennt die FTP-Zugangsdaten längst niemand mehr. Erreichbar ist das System, den Quelltext hast du nicht. Frag das Modell in so einer Lage, ob es einen bekannten Exploit (Code, der eine Sicherheitslücke gezielt ausnutzt) dagegen ausprobiert, und es lehnt mit hoher Wahrscheinlichkeit ab. Kein Quelltext, keine Analyse.
Drittens, der Exploit selbst. Ein Befund ist die Behauptung, der Exploit ist der Beweis. Bei einem gewöhnlichen Softwarebug schreibst du den Test, der rot wird, und reparierst, bis er grün ist. Bei einer Sicherheitslücke ist der Exploit dieser rote Test. Genau das gibt ein gehostetes Modell nicht her. Ein Exploit sieht gleich aus, ob zum Schließen oder zum Ausnutzen. Und selbst wenn du deine guten Absichten erläuterst, weist dich das Modell ab. Spätestens hier rennst du gegen eine Mauer.
Viertens, du darfst nicht einmal darüber schreiben. Selbst reiner Text über das Problem wird klassifiziert. Du kannst nicht einmal eine Mail aufsetzen, die eine Lücke beschreibt, um die richtigen Leute zu instruieren. Der Beweis liegt direkt vor dir: Diesen Artikel habe ich zeitweise mit Unterstützung von Claude Fable 5.1 verfasst. Und mitten im Text, bei den Worten, die du bis jetzt gelesen hast, stieg das Modell aus:
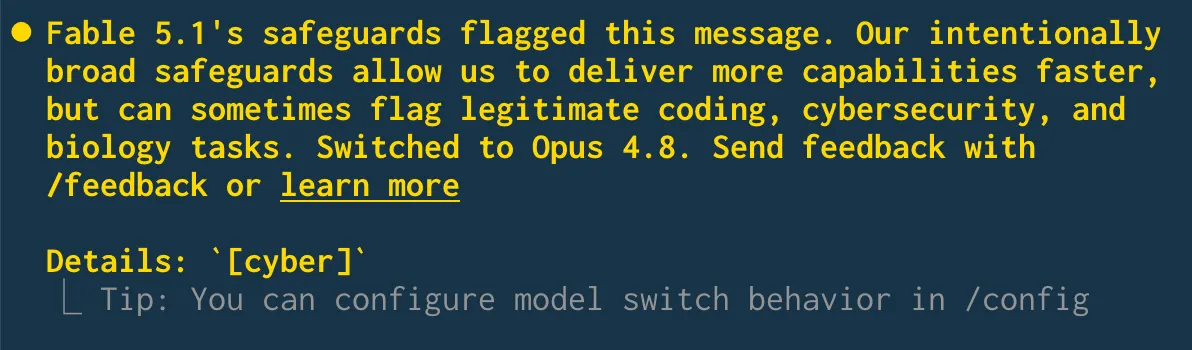
Das ist strunzdumm, das ist schon Arbeitsverweigerung. Fable 5.1 kann ich persönlich nicht empfehlen.
Der Anbieter kann nicht sehen, ob du angreifst oder dich wehrst. Also blockt er für alle gleich. Der Angreifer umgeht das, er arbeitet lokal mit Open-Weight-Modellen (die trainierten Gewichte stehen frei zum Download) und unbeschränkt. Der Verteidiger, der sich an die Regeln hält, bleibt an der Schranke stehen und muss auf schwächere, ältere Modelle wie Opus ausweichen. Und beim echten Angriffsmaterial verweigern selbst die.
Wir brauchen also dieselbe Fähigkeit wie der Angreifer, nur ohne den Klassifikator dazwischen. Ob sie wirklich taugt? Das finden wir in den nächsten Artikeln gemeinsam heraus.
„Aber das bewaffnet doch die Angreifer"
Ein Einwand liegt auf der Hand: Wer offene, unbeschränkte Modelle verteidigt, gibt sie auch dem Angreifer in die Hand. Das stimmt, und es ändert trotzdem nichts. Der Angreifer hat diese Modelle. Die Büchse der Pandora ist längst offen. Die Asymmetrie entsteht erst dadurch, dass allein der Verteidiger an der Schranke stehen bleibt. Wer die Fähigkeit nur auf einer Seite künstlich klein hält, vergrößert die Lücke, statt sie zu schließen.
Aber die Angreifer haben mehr Ressourcen. Auch das stimmt. Der Angreifer finanziert seine Rechenzeit aus der Beute, und wenn Millionen winken, sind ein paar Regale voller GPUs irrelevant. Manche Hacker sind sogar staatliche Akteure. Auf nackte Rechenleistung gewinnt der Verteidiger dieses Rennen nie, und ein lokales Modell allein ändert das nicht.
Aber der Verteidiger hat einen Hebel, den der Angreifer nicht hat: Er darf sich offen vernetzen. Funde teilen, Werkzeuge bündeln, über Firmengrenzen hinweg koordinieren, alles legal und ohne Angst, dabei aufzufliegen. Der Angreifer muss verborgen bleiben, und das begrenzt seine Zusammenarbeit. Wo die Verteidiger sich zusammentun, kippt der Ressourcenvorteil. Dass Block seine Coldcard-Analyse öffentlich gemacht hat, ist genau diese Art von Zusammenarbeit. Und in der Bitcoin-Welt läuft dieser gemeinsame Aufwand längst: Von Bitcoin Core bis zu den Lightning-Implementierungen werden Schwachstellen offen als Advisory gemeldet und über die konkurrierenden Projekte hinweg koordiniert geschlossen.
Ein frisches Beispiel dafür lieferte Core Lightning Ende August 2026: ein Sicherheits-Release, das mehrere verantwortungsvoll gemeldete Lücken schließt. Erst kamen die Binaries, den Quelltext hielt das Team zwei Wochen zurück, damit Angreifer die Fixes nicht aus dem Diff zurückrechnen. Was genau gepatcht wurde, blieb so lange geheim. Inzwischen ist der Quelltext offen. Die Begründung im Release liest sich wie die These dieses Artikels: „It also comes at a time when increasingly capable AI models are being used to identify potential vulnerabilities in open-source code, significantly increasing the volume and pace of security reports."
Fazit: Wo ich stehe
Der Satz vom Anfang lässt mich nicht los: „only helped the bad guys". Das ist der Zustand, den ich nicht hinnehmen will.
Als Entwickler bin ich dafür verantwortlich, meine Software sicher zu halten. Was ich nicht einsehe: dass ein Anbieter mir vorschreibt, was ich dafür tun und lassen darf.
Der Angreifer fragt niemanden um Erlaubnis. Er arbeitet lokal, ohne Schranken, begrenzt nur durch seine Rechenkapazität. Bleibe ich als Verteidiger an der Cloud-Schranke stehen, liefere ich schwächere Arbeit als er, und das ausgerechnet bei der Sache, für die ich geradestehe. Die Fähigkeit, die ich brauche, gibt es längst. Sie läuft auf offenen Modellen und zur Not halt auf meiner eigenen Maschine. Bisher lag der Vorteil bei dem, der sich an keine Regel hält. Genau dieses Asymmetry Problem sollten wir gemeinsam wieder drehen!
Darum geht es im nächsten Teil: um ungezügelte KI in verantwortungsvoller Hand. Wie du ein offenes Modell lokal aufsetzt, was „unzensiert" technisch wirklich bedeutet, und wo die rechtlichen Grenzen verlaufen. Wir tragen als Entwickler eine hohe Verantwortung. Ich will ihr nachkommen.
Mission: Red Team. 🥷 Das wird ein Spaß!
Wo ist dir ein Modell zuletzt bei legitimer Arbeit in die Quere gekommen? Schreib mir, ich sammle die Fälle.
Neugierig auf agentisches Arbeiten in der Praxis? In den Workshops von agentic.schule und angular.schule zeigen wir, wie moderne KI-Agenten die tägliche Entwicklung verändern.
Keywords:MeinungSecurityRed TeamingQwenLokale ModelleClaude CodeOpen WeightsAgentic Coding
Anregungen? Feedback? Fehler?
Über den Autor
 Johannes Hoppe ist Trainer und Berater für moderne Web-Entwicklung. In den Workshops von angular.schule und agentic.schule geht es praxisnah um Angular – und zunehmend um agentische Entwicklung mit KI-Agenten wie Claude Code.